Wenn richtige KI-Antworten durch unsere Tests fallen
Wer bei der AIC Group KI-Assistenten entwickelt, kennt die Momente, in denen man auf ein rotes Testergebnis schaut und denkt: „Warum versteht die KI das denn immer noch nicht?”
Diesmal teile ich keine eigene Erkenntnis, sondern eine aus unserer Softwareentwicklung. Es ist der erste Artikel aus dieser Richtung, und ich hoffe, es bleibt nicht der letzte, denn gerade dort spielen KI-Agenten eine immer größere Rolle. Das Team hat zwei solcher Momente aufgeschrieben und was es daraus gelernt hat.
Wir wollten, dass unser KI-Assistent Menschen ab 18 Jahren auswählt. Er schlug „älter als 17” vor. Unser Test meldete einen Fehler.
Bei einem Alter, das in ganzen Jahren gespeichert wird, treffen beide Bedingungen dieselben Menschen. Der rote Test hatte uns zunächst mehr über unsere Erwartung an die Antwort verraten als über das Verständnis des Modells.
Bei genauerem Hinsehen waren einige Antworten fachlich richtig. Unsere Prüfung verlangte allerdings eine bestimmte Form. An anderer Stelle sollte das Modell eine Tatsache beurteilen, die unsere Software bereits eindeutig prüfen konnte. Zwei unterschiedliche Ursachen, die zunächst beide wie ein Verständnisproblem der KI aussahen.
Der gemeinsame Gedanke dahinter: Beim Entwerfen eines Agentenprompts sollten wir bewusst festlegen, welche Entscheidungsfreiheit das Modell tatsächlich braucht. Fachlich gleichwertige Lösungen dürfen Spielraum haben. Bereits feststehende Tatsachen müssen dagegen nicht erneut zur Entscheidung gestellt werden.
1. Das gewünschte Ergebnis prüfen
„Mindestens 18” und „größer als 17” sind für ganze Altersjahre gleichwertig. Wer nur die erste Form als Musterlösung hinterlegt, weist die zweite zurück, obwohl sie den Auftrag erfüllt.
Soll die KI genau unsere Musterantwort liefern, oder soll sie das gewünschte fachliche Ergebnis erreichen?
Zur Geschichte gehört die Grenze: Bei Dezimalzahlen funktioniert die Gleichsetzung nicht. 17,5 ist größer als 17, aber noch nicht mindestens 18. Und für unbekannte Alterswerte müssen wir festlegen, was gelten soll. In unserem Beispiel zählen sie nicht zur gewünschten Gruppe. Ob die eingesetzte Software das tatsächlich so ausführt, muss zusätzlich geprüft werden.
Die praktische Konsequenz: Vor dem Test das Ziel, den gültigen Datenbereich und zulässige Varianten festlegen. Dazu Gegenbeispiele prüfen. Eine abweichende Schreibweise ist nicht automatisch ein fachlicher Fehler; eine ähnliche Antwort ist umgekehrt noch lange keine richtige Lösung.
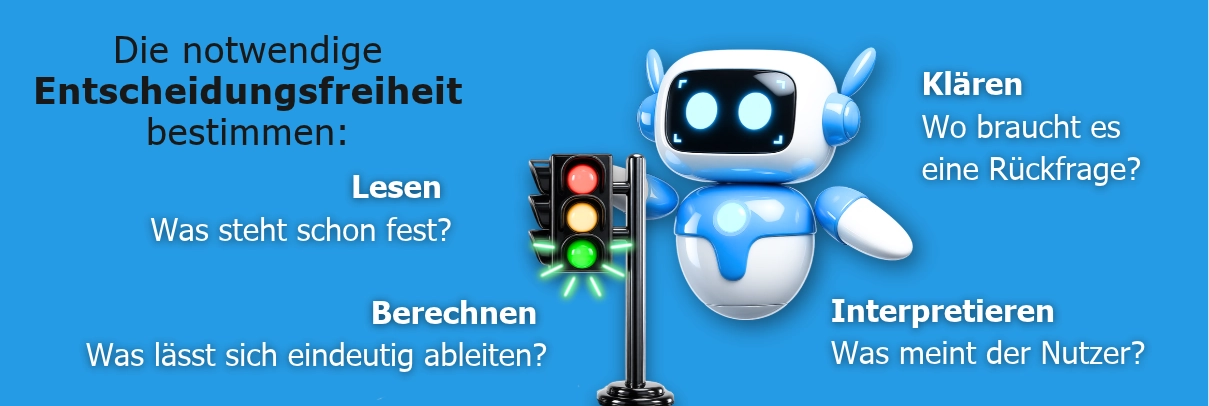
2. Die notwendige Entscheidungsfreiheit bestimmen
Ein Agentenprompt legt auch fest, worüber das Modell entscheiden soll. Deshalb lohnt sich bei jeder verlangten Angabe und jeder angebotenen Handlung die Frage:
Brauchen wir hier wirklich eine Entscheidung des Modells, oder steht die Antwort durch Daten, Regeln oder den aktuellen Arbeitsstand bereits fest?
Ein zusätzlicher Satz wie „Entscheide dabei immer richtig” beseitigt eine unnötige Wahlmöglichkeit nicht. Wo eine Voraussetzung eindeutig prüfbar ist, kann die Anwendung sie vorab prüfen und die angebotenen Möglichkeiten daran ausrichten. Das Modell behält den Spielraum, den es zum Verstehen und Lösen der eigentlichen Aufgabe benötigt.
Ein Nutzer spricht von seiner „Newsletteradresse”. Das Modell findet das richtige Feld und gibt die Worte des Nutzers korrekt wieder. In einem zusätzlichen Ausgabefeld behauptet es jedoch, der Nutzer habe den technischen Feldpfad wörtlich genannt. Unsere Prüfung weist die Antwort deshalb ab.
Hier stecken zwei verschiedene Aufgaben drin:
- Welches Feld meint der Nutzer? Das erfordert Verständnis für Sprache, Feldbeschreibungen und den jeweiligen Zusammenhang. Bei Mehrdeutigkeit braucht es eine Rückfrage.
- Steht der vollständige technische Feldpfad im Text? Das kann die Software eindeutig prüfen. Dafür braucht sie kein Sprachmodell.
Unsere daraus abgeleitete Designrichtung: Fehlt der technische Pfad im Nutzertext, sollte „wörtlich genannter Pfad“ für dieses Feld gar nicht zur Auswahl stehen. Welches Feld mit „Newsletteradresse” gemeint ist, bleibt dagegen eine Interpretationsaufgabe.
Diese Grenze gehört sowohl in den Prompt als auch in die tatsächlich angebotenen Aktionen und Ausgabeformen. Eine falsche Antwort hinterher passend umzudeuten, wäre etwas anderes und würde den eigentlichen Fehler verdecken. Ebenso wenig soll die Anwendung bei echter Mehrdeutigkeit heimlich eine Auswahl treffen.
Zum Stand: Die neue Altersbewertung haben wir intern getestet. Die vorab eingeschränkte Pfadauswahl ist die nächste Designänderung, deren Wirkung wir noch überprüfen. Alle Modellfehler haben wir damit nicht gelöst.
Die Merkhilfe
Bekannte Fakten aus der zuständigen Quelle lesen. Eindeutige Ableitungen berechnen. Bedeutung interpretieren. Offene Entscheidungen klären.
Zum Mitnehmen: fünf Fragen vor der nächsten Prompt- oder Modellwechselrunde
- Woran erkennen wir fachlich, dass der Auftrag erfüllt ist?
- Welche unterschiedlichen Lösungen dürfen dieses Ziel erreichen?
- Welche Angaben sind durch verlässliche Quellen oder eindeutige Berechnung bereits festgelegt?
- Welche Entscheidungsfreiheit braucht das Modell – und welche Wahlmöglichkeiten sind unnötig?
- Wo bleiben echte Interpretation, Mehrdeutigkeit oder eine Rückfrage an den Nutzer?
Die beiden Erkenntnisse ergänzen sich: Spielraum für fachlich richtige Lösungen erhalten und vermeidbare Entscheidungen aus dem Modellauftrag nehmen. Zur Qualität eines KI-Assistenten gehört auch die Qualität der Aufgaben und Prüfungen, die wir um ihn herum bauen.
Habt ihr schon einmal einen vermeintlichen KI-Fehler gefunden, der eigentlich in eurem Prüfmaßstab steckte?
Schreibt uns. Wir teilen unser Vorgehen gern.