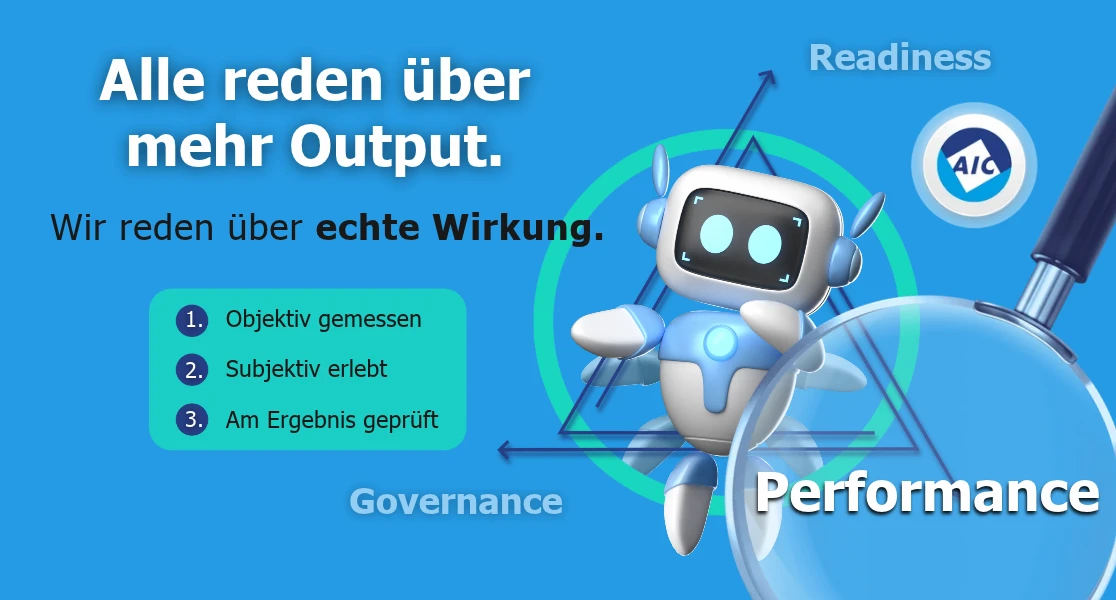
Alle reden über mehr Output. Wir reden über echte Wirkung.
Im letzten Artikel ging es um Governance: wer einsetzt, wer prüft, wer verantwortet. Bleibt die unbequemste Frage der ganzen Reihe. Lohnt sich das eigentlich?
Die ROI-Frage führt zu erfundenen Zahlen
„Was bringt uns das an ROI?“ klingt sauber. In der Praxis schätzt man, wie lange etwas vorher gedauert hat, misst, wie lange es jetzt dauert, multipliziert mit einem Stundensatz und hat ein Ergebnis. Nur ruht das Ganze auf einer Erinnerung.
Wir kennen das aus eigener Anschauung. Bei der AIC Group haben wir mit unseren Agenten angefangen, ohne vorher systematisch zu messen. Heute haben wir den deutlichen Eindruck, schneller geworden zu sein. Belegen können wir ihn nur zum Teil.
Was weiterhilft, sind drei Fragen. Keine reicht allein.
1. Objektiv: Was dauerte es vorher?
Der Weg: einen konkreten Prozess nehmen und messen. Dauer, Korrekturschleifen, Häufigkeit. Nach jeder Ausbaustufe des Agenten erneut, einschließlich der Zeit fürs Prüfen und Nacharbeiten. Wer nur die Erstellung stoppt, misst die halbe Arbeit. So entsteht eine Reihe statt einer einzelnen Prozentzahl, und an ihr lässt sich ablesen, wann weiterer Ausbau sich nicht mehr rechnet.
Die Grenze: Läuft der Agent, ist der Zustand davor weg. Übrig bleibt ein Gefühl, und das täuscht. In einem kontrollierten Versuch der Forschungsorganisation METR brauchten erfahrene Entwickler 2025 mit KI-Werkzeugen 19 Prozent länger und waren hinterher überzeugt, 20 Prozent schneller gewesen zu sein. Eine kleine Studie mit den Werkzeugen von damals. Die Lücke zwischen gefühlt und gemessen bleibt trotzdem lehrreich.
Was sich nachholen lässt: Ticketsysteme und Dateiversionen kennen oft noch die Durchlaufzeiten von früher. Und eine Handvoll gleichartiger Aufgaben, mal mit Agent, mal ohne, macht aus einem Gefühl zumindest einen Anhaltspunkt.
Unser Stand: Hier haben wir die größte Lücke.
2. Subjektiv: Was fällt Dir seitdem leichter?
Ein Teil der Wirkung taucht in keiner Messung auf. Eine Aufgabe, vor der man sich gedrückt hat, wird plötzlich am Montagmorgen erledigt. Ein Entwurf entsteht, ohne dass man vorher zwanzig Minuten auf ein leeres Dokument geschaut hat.
Ein Beweis für Tempo ist das nicht. Es beantwortet eine andere Frage: ob der Agent bleibt. Wo Entlastung spürbar ist, wächst die Nutzung von selbst. Wo nur Zeit gespart wird, schläft sie ein. Ein Stück davon lässt sich sogar zählen: Wird der Agent nach drei Monaten noch täglich geöffnet?
Den Rest erfährt man im Gespräch, regelmäßig und konkret. Was fällt Dir seitdem leichter? Was machst Du inzwischen, was Du vorher vor Dir hergeschoben hast? Wo nervt es noch?
Unser Stand: viel Erfahrung, wenig davon aufgeschrieben.
3. Ergebnis: Hält die Qualität bei mehr Menge?
Die dritte Frage schaut auf das, was am Ende herauskommt. Bei uns im Marketing sind das Reichweiten, Klicks und Interaktionen der Beiträge, an denen der Agent mitgearbeitet hat. Jede Veröffentlichung läuft mit ihren Kennzahlen in unsere Planung zurück.
Die Grenze: Diese Zahlen messen die Qualität des Ergebnisses, nicht den Beitrag der KI. In unseren Auswertungen laufen Formate mit Menschen deutlich besser als Produkterklärungen. Das ist eine Erkenntnis über Formate. Sie der KI zuzuschreiben, wäre bequem und falsch.
Was die Zahlen können: zeigen, ob die Qualität hält, während die Menge steigt. Dazu passt eine einfache Größe für jeden Agenten, der Entwürfe liefert: Wie viel vom Entwurf übersteht die Überarbeitung?
Und ein Prinzip aus der Softwareentwicklung: ein kleiner, fester Satz Testaufgaben, der nach jeder Anpassung am System Prompt oder an der Wissensbasis erneut durchläuft. Er zeigt, ob die Verbesserung an einer Stelle woanders etwas verschlechtert hat. Bei unserem eigenen Agenten gibt es diesen Satz noch nicht.
Unser Stand: Hier sind wir am weitesten.
Drei Fragen zum Mitnehmen
Was dauerte es vorher? Messen, bevor der Agent läuft, Prüfzeit inklusive. Verpasst? Alte Systemdaten auswerten oder ein kleiner Vergleich mit und ohne Agent.
Was fällt Dir seitdem leichter? Regelmäßig fragen und die Nutzung zählen.
Hält die Qualität bei mehr Menge? Auf Konstanz schauen statt auf Zuwachs, und Anpassungen mit festen Testaufgaben absichern.
Erst alle drei zusammen beantworten die Frage vom Anfang, ohne eine Zahl, die man erfinden musste.
Und dann fängt es wieder an
Was die Messung zeigt, wird zur nächsten Anpassung: eine Lücke in der Wissensbasis, eine Leitplanke, die zu eng sitzt, eine Aufgabe, die der Agent besser gar nicht übernimmt.
Damit sind alle drei zusammen: Readiness klärt, ob das Team tragen kann. Governance klärt, wer verantwortet. Performance klärt, ob es wirkt.
Beim nächsten Mal schauen wir zurück auf alles, was in dieser Reihe zusammengekommen ist. Und nach vorn.
Schreibt uns. Wir teilen unser Vorgehen gern.